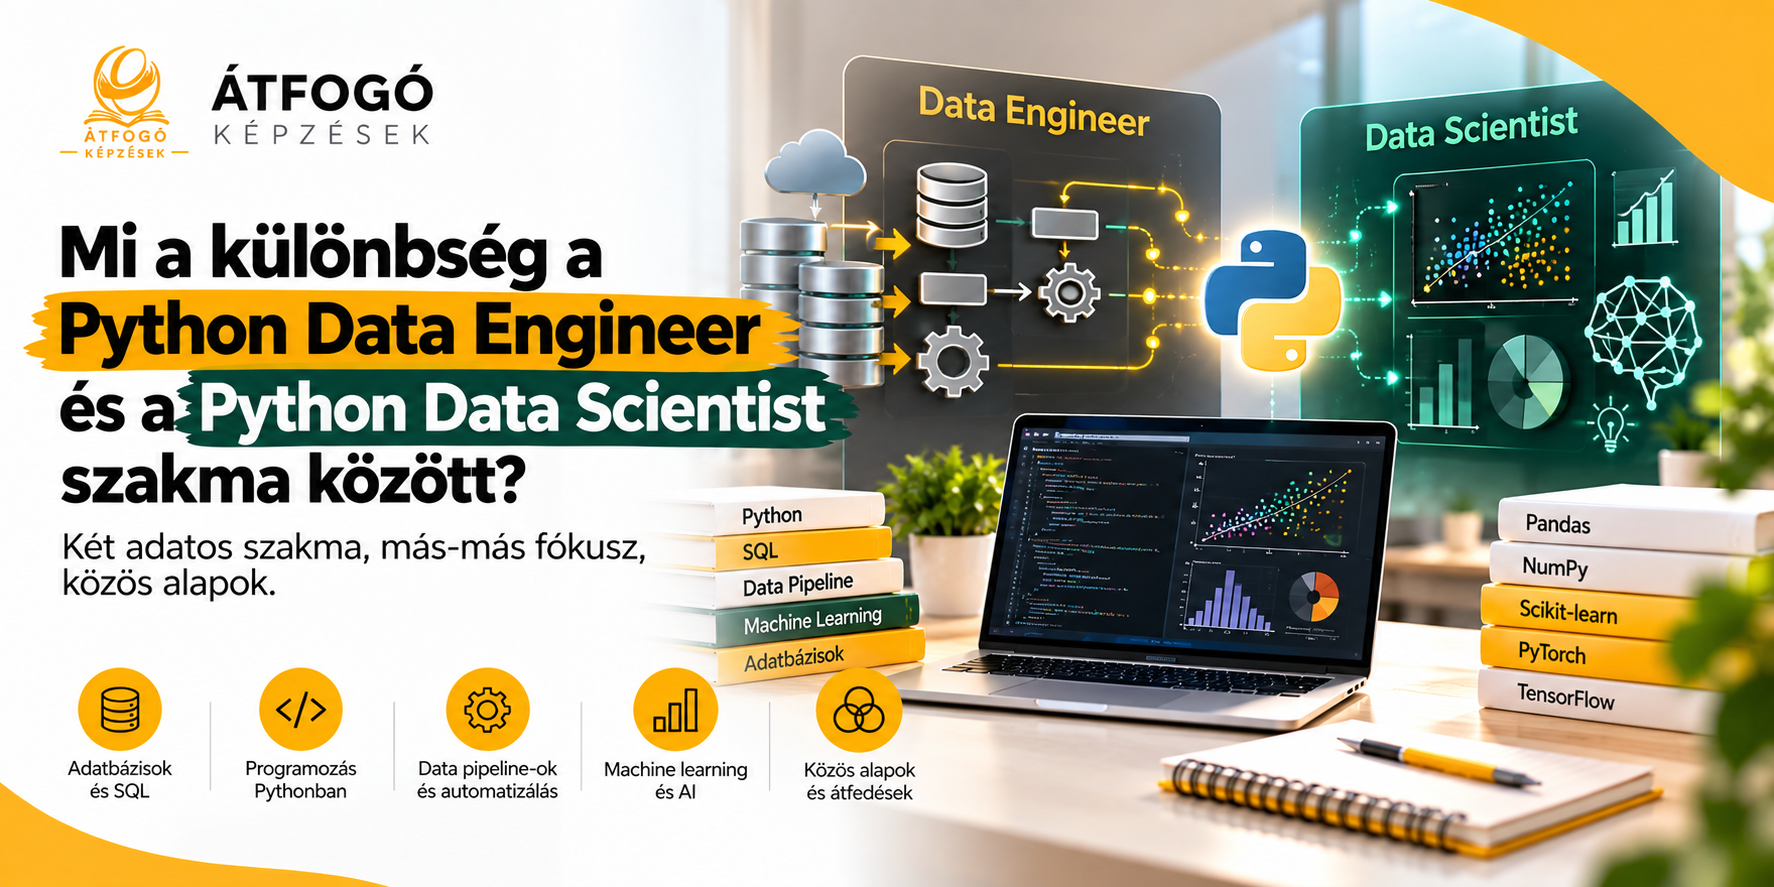
A Data Engineer és a Data Scientist munkaköre között van kapcsolat és átmenet, ugyanakkor a két szakma más-más területre helyezi a hangsúlyt.
Mindkét munkakörben fontos az adatokkal való munkavégzés, a programozás és az adatbázisok ismerete, de a feladatok és a fókusz eltérő lehet.
Röviden megfogalmazva: a Data Engineer azért felel, hogy a Data Scientist által használt adatok rendezettek, strukturáltak és elérhetőek legyenek, míg a Data Scientist azért dolgozik, hogy adott üzleti problémára machine learning vagy AI megoldást készítsen.
Mit csinál egy Data Engineer?
A Data Engineer munkájának jelentős része a data pipeline-ok fejlesztése és üzemeltetése.
A Data Engineer leggyakoribb feladatai közé tartozik:
a Data Platform fejlesztése,
a Data Pipeline fejlesztése,
az adatbázisok fejlesztése,
a pipeline-ok automatizálása.
Az, hogy pontosan milyen további feladatok tartoznak a Data Engineer munkakörébe, cégfüggő lehet.
A Data Engineer sok esetben toolokat és platformokat is fejleszt, illetve tart karban annak érdekében, hogy a Data Scientist el tudja látni a feladatait.
A Data Engineering szerepe az adatfeldolgozásban egyre fontosabb. Egy vállalat életében rengeteg adat keletkezik, a Data Engineering pedig olyan best practice-ek gyűjteménye, amelyek segítenek abban, hogy ezeket az adatokat a vállalat feldolgozza és elérhetővé tegye.
Ez például céges riportálásnál is fontos lehet, amikor a nagy mennyiségű adatok integrálását kell megoldani.
Mit csinál egy Data Scientist?
A Data Scientist ezzel szemben elsősorban üzleti problémákkal foglalkozik.
Egy példa erre, amikor egy cégnek van egy szolgáltatása, azonban az ügyfelek egy bizonyos idő után felhagynak a használatával. Ez egy üzleti probléma.
A Data Scientist az adatok értelmezésével megpróbálhatja meghatározni azokat a tényezőket, amelyek miatt az ügyfél elhagyja a szolgáltatást.
Az erre adott választ később akár automatizált formában is lehet használni, és adott esetben ennek segítségével javítani lehet a szolgáltatáson vagy akár teljesen megváltoztatni azt.
A Data Scientist tehát egy adott problémához meghatározza a módszertant, és előállítja azt az üzleti logikát, amely a probléma megoldásához szükséges.
Hol van átfedés a két szakma között?
A két munkakör között van átmenet.
Mindkét szakembernek értenie kell az adott platform képességeihez, amelyen dolgozik. Mindkét munkakörben fontos az adatbázisok és az API-k ismerete, valamint a machine learning alapfogalmainak és módszertanainak ismerete.
Erre azért van szükség, hogy a két szakember együtt megbízható és skálázható megoldást tudjon fejleszteni.
A Data Engineer egyik feladata, hogy a Data Scientist a lehető legautomatizáltabb formában tudja ellátni a munkáját.
Ha nagyon leegyszerűsítjük a két munkakör közötti különbséget, akkor azt mondhatjuk:
A Data Engineer az utat építi, a Data Scientist pedig értelmezi az adatokat.
Miért fontos a Python mindkét munkakörben?
A Python a legelterjedtebb technológia mindkét munkakör számára.
Ennek egyik oka, hogy jelenleg a Pythonnak van a legnagyobb adatos és machine learning library-gyűjteménye olyan megoldásokkal, amelyek iparági standardot képeznek.
A Data Scientist főként az ML- és plotting library-kat használja, míg a Data Engineer elsősorban az orchestratorokkal és az adatfeldolgozáshoz fejlesztett megoldásokkal dolgozik.
A Data Scientist által használt technológiák között például megtalálható:
Pandas,
NumPy,
Seaborn,
PyTorch,
TensorFlow,
Scikit-learn,
Keras.
Az, hogy pontosan melyik technológiát használja egy Data Scientist, szintén attól függhet, hogy hol dolgozik.
Az SQL és az adatbázisok ismerete elengedhetetlen
A Python mellett az adatbázisok és az SQL ismerete is elengedhetetlen.
Mindkét munkakör nagymennyiségű adatokkal dolgozik, amelyeket strukturálni és validálni kell. Ez az ismeret szinte elengedhetetlen ahhoz, hogy a napi munkavégzést el lehessen látni.
A legfontosabb alapok között ezért nemcsak a programozási ismeretek, hanem az adatbázis-ismeretek is szerepelnek.
Mi az a data pipeline?
A data pipeline-ok olyan egységek, amelyek az adat feldolgozásának lépéseit tartalmazzák.
A legtöbb esetben az a cél, hogy a folyamat automatizálva legyen, vagy a lehető legkevesebb manuális munkával fusson le.
Egy általános adatpipeline tartalmazhatja:
az adatok elhozatalát a forrásrendszerből,
az adatok ellenőrzését és validációját,
az esetleges transzformációkat,
az adatok célrendszerbe történő integrálását.
Fontos azonban, hogy minden use-case más és más lépéseket igényelhet.
Egy adatpipeline akár roppant bonyolult is lehet, és az életciklusa alatt rengeteg változtatás történhet rajta.
Miért fontos a Git a Data Engineeringben?
Ahhoz, hogy a pipeline-ok változásai ismertek és nyomon követhetőek legyenek, szükség van verziókövetésre.
Erre a célra jelenleg a Git verziókezelő megoldás a legelterjedtebb.
Egy adatpipeline futása során nagyon sok művelet történhet, például:
adattisztítás,
validáció,
adatbetöltés.
A különböző adatplatformok más és más módon oldják meg ezeket a műveleteket.
Mire használható a Docker?
A Docker akkor kerül képbe, amikor az adott platform a konténerizációt választotta arra, hogy egy adott feladatot vagy több feladatot el tudjon végeztetni.
A Data Engineeringben tehát a Docker szerepe attól függ, hogy az adott adatplatform milyen megoldást választott a feladatok futtatására.
Mi az Apache Airflow szerepe?
Egy Data Engineer több data pipeline-t fejleszt.
Ezek fejlesztése, karbantartása, futtatása és üzemeltetése egy idő után elég nagy kihívást jelenthet.
Az Apache Airflow egy orchestration megoldás, amelynek célja, hogy központosított helyen futtassa a data pipeline-okat, ezáltal egységes rendszert biztosítva azok üzemeltetésére, karbantartására és élesítésére.
Mennyire fontos a matematika a Data Scientist számára?
A Data Scientist számára a matematika és a statisztika elengedhetetlen.
A Data Scientist olyan statisztikai számításokat és kalkulációkat használ a munkájához, amelyek adott problémákra lettek létrehozva.
Nem szükséges matematikus képzést végezni, de az egyetemi szintű matematikai és statisztikai tudás nagyon fontos.
A Data Engineering esetében ezzel szemben nem szükséges ilyen szintű matematikai tudás. Ha valaki nem rajong a matematikáért, akkor a Data Engineering sokkal jobban feküdhet számára.
Ez azonban nem jelenti azt, hogy a Data Engineeringhez ne lenne szükség absztrakt gondolkodásra. Az architekturális tervezés és az algoritmikus ismeretek ezen a területen is fontosak.
Minden Data Scientist dolgozik deep learninggel vagy Agentic AI-jal?
Nem feltétlenül.
Cégfüggő, hogy egy Data Scientist egyáltalán dolgozik-e neurális hálókkal, deep learninggel vagy Agentic AI-al.
Van olyan hely, ahol a Data Scientist feladata a klasszikus statisztikai modellfejlesztésre korlátozódik, míg máshol a Data Scientist felel mindenért, ami ML és AI témakör.
Ezért a munkakör pontos tartalma jelentősen eltérhet attól függően, hogy hol dolgozik az adott szakember.
Fontosabb a programozás vagy az adatkezelés?
Mindkét munkakör alapvetően a programozás köré szerveződik.
Ha különbséget kell tenni, akkor a Data Engineering során fontosabb az alapvető programozási paradigmák betartása, és nagyobb fókusz jut az automatizálásra.
A Data Engineer feladata néha az is, hogy segítsen abban, hogy a Data Scientist által fejlesztett megoldások üzemeltethetőek és hosszú távon skálázhatóak legyenek.
Hogyan változtathatja meg az AI a Data Engineeringet?
A jelenlegi AI Agentek nagyon jók lehetnek a kódolásban és a megtanult architektúrák reprodukálásában.
Egy olyan szakember számára, aki mélységében érti a technológiát, a patterneket és az architektúrákat, ez nagyon nagy segítséget jelenthet abban, hogy az AI-al gépeltessen le kódot.
A validáció azonban fontos.
Az AI Agentek használata jelenleg az automatizálás irányába halad. Ez ugyanakkor trükkös helyzeteket is okozhat, például egy modellverzió váltása vagy a tokenárak emelkedése miatt.
Egy biztos: a következő években egyre jobban fognak terjedni az AI Agentek és a self-hosted megoldások.
Milyen alapokra érdemes koncentrálni?
A legfontosabb, hogy a programozási és adatbázis-ismereti alapok biztos lábakon álljanak.
Nem a library-k ismerete a legfontosabb, mert azok sokkal könnyebben megtanulhatók, mint például az, hogy hogyan fejlesszünk moduláris vagy skálázható megoldást.
Mindkét munkakörben az adatokkal való munkavégzés a cél.
Ezért különösen fontos:
az adattisztítás,
az adatbetöltés,
az adatkinyerés,
a különböző fájltípusok ismerete.
A szakmai alapok kialakításakor ezekre érdemes kezdetben a hangsúlyt fektetni.
Data Engineer vagy Data Scientist?
A két szakma között tehát van átfedés, de eltérő fókusz jellemzi őket.
A Data Engineer elsősorban az adatok elérhetőségéért, strukturálásáért és az adatfeldolgozási folyamatokért felel. Data pipeline-okat, platformokat és különböző technikai megoldásokat fejleszt és üzemeltet.
A Data Scientist elsősorban üzleti problémák megoldására használja az adatokat, és machine learning vagy AI megoldásokat készíthet.
Mindkét területen fontos a programozás, az adatbázisok ismerete és az adatokkal való munkavégzés. A különbség többek között abban jelenik meg, hogy a Data Engineeringben nagyobb hangsúly kerülhet az automatizálásra, a rendszerekre és a skálázhatóságra, míg a Data Science-ben fontos szerepet kap a matematika, a statisztika és az üzleti problémák elemzése.
A két szakember munkája ugyanakkor szorosan kapcsolódhat egymáshoz: a Data Engineer biztosítja azt a technikai hátteret és adatfolyamot, amelyre a Data Scientist a munkája során támaszkodni tud.